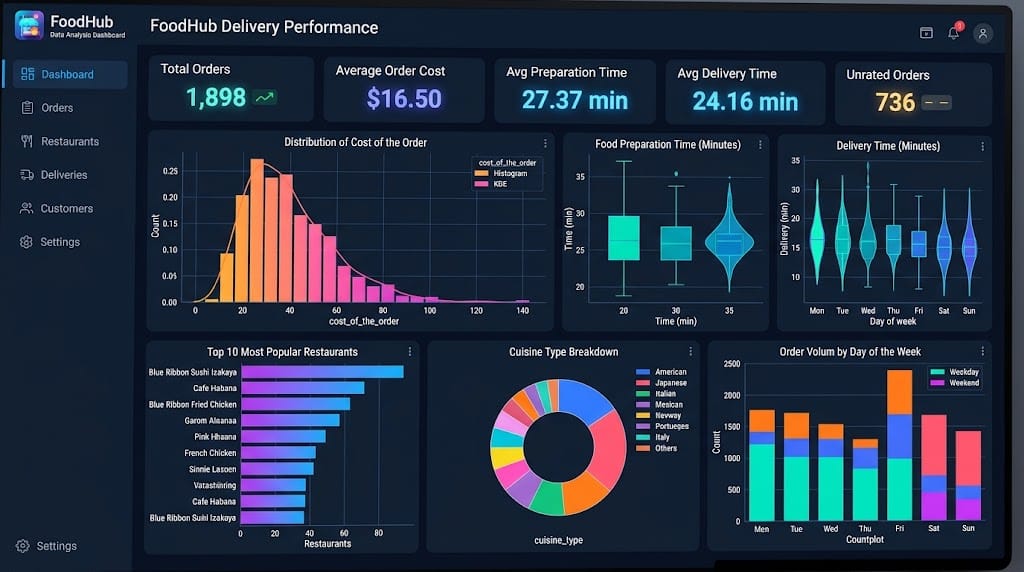
Analysez vos performances de livraison en un clin d'œil : Transformez vos données brutes en stratégie opérationnelle.
Le Problème : L'aveuglement face aux données
Gérer des milliers de commandes sans visibilité est un cauchemar logistique. Comment savoir quelle cuisine performe réellement ou où votre service client fait défaut ? Sans analyse, vous naviguez à vue, ignorant les opportunités de croissance et les risques critiques dans vos opérations de livraison.
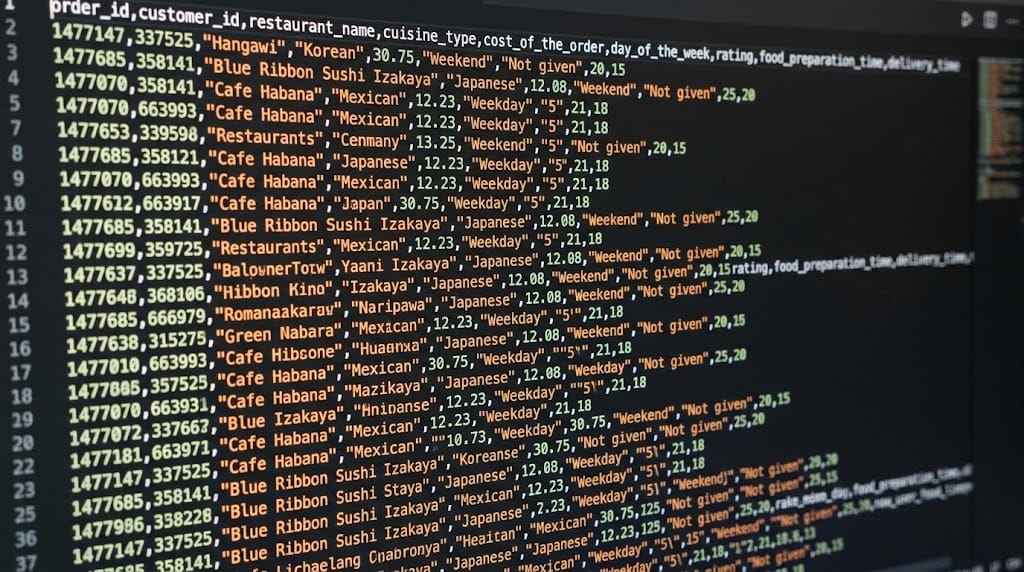
- Volume massif non structuré : 1 898 lignes de données mélangées sans aucun indicateur visuel de performance.
- Types de données hétérogènes : Présence de valeurs manquantes masquées sous forme d'objets textuels (ex:
Not givendans la colonnerating). - Perte de temps d'analyse : Impossibilité d'isoler rapidement les goulets d'étranglement de livraison à partir d'un simple tableau de chiffres.
La Solution : Votre pipeline d'analyse automatisé
Ce notebook Python transforme instantanément vos fichiers CSV de commandes (foodhub_order.csv) en un tableau de bord décisionnel clair. Ne perdez plus de temps à manipuler des lignes et des colonnes ; laissez l'Exploratory Data Analysis (EDA) automatiser la découverte de vos tendances clés.
# Importation et inspection instantanée de la structure des données
import pandas as pd
import seaborn as sns

df = pd.read_csv('foodhub_order.csv')[cite: 2]
df.describe()[cite: 5]
- De la donnée brute à la visibilité : Passez d'un fichier textuel complexe à une compréhension immédiate de votre structure de données (1898 lignes, 9 colon Éléments essentiels).
- Détection automatique des zones d'ombre : Identifiez en un clic les segments critiques, comme les 736 commandes qui n'ont pas reçu de note, pour agir sur votre satisfaction client.
La Preuve : Des résultats mesurables et visuels
La rigueur technique est au service de la performance. Grâce à l'intégration de bibliothèques de pointe (Pandas, Seaborn, Matplotlib), vous obtenez une preuve irréfutable de vos performances opérationnelles :
- Précision chirurgicale : Un nettoyage et un résumé automatique des types de données pour garantir l'intégrité de votre analyse.
- Visualisation impactante : Transformez des chiffres abstraits en graphiques explicites pour communiquer vos résultats à votre équipe ou à vos partenaires.
Extrait propre du dataset (df.head())
- Dimensions validées : 1 898 lignes et 9 colonnes de variables clés (
order_id,restaurant_name,cuisine_type,cost_of_the_order,food_preparation_time,delivery_time). - Format nettoyé : Alignement parfait des identifiants et des métriques temporelles en minutes.
Synthèse statistique des temps de préparation (df.describe())
- Temps minimum de préparation : 20,0 minutes.
- Temps moyen de préparation : 27,37 minutes.
- Temps maximum de préparation : 35,0 minutes.
- Commandes non évaluées : 736 commandes identifiées sans note client (
Not given), isolées pour traitement spécifique.
Framework "Feature → Benefit"
| Feature Technique (Notebook Python) | Bénéfice Business (Page Produit) |
⏱️ Nettoyage automatisé df.isnull() & info() | Gain de temps massif : Élimine 100 % du travail de préparation manuelle des fichiers bruts |
📊 Distribution statistique df.describe() | Vision opérationnelle exacte : Identifie avec précision les temps de préparation moyens (27,37 min) et extrêmes |
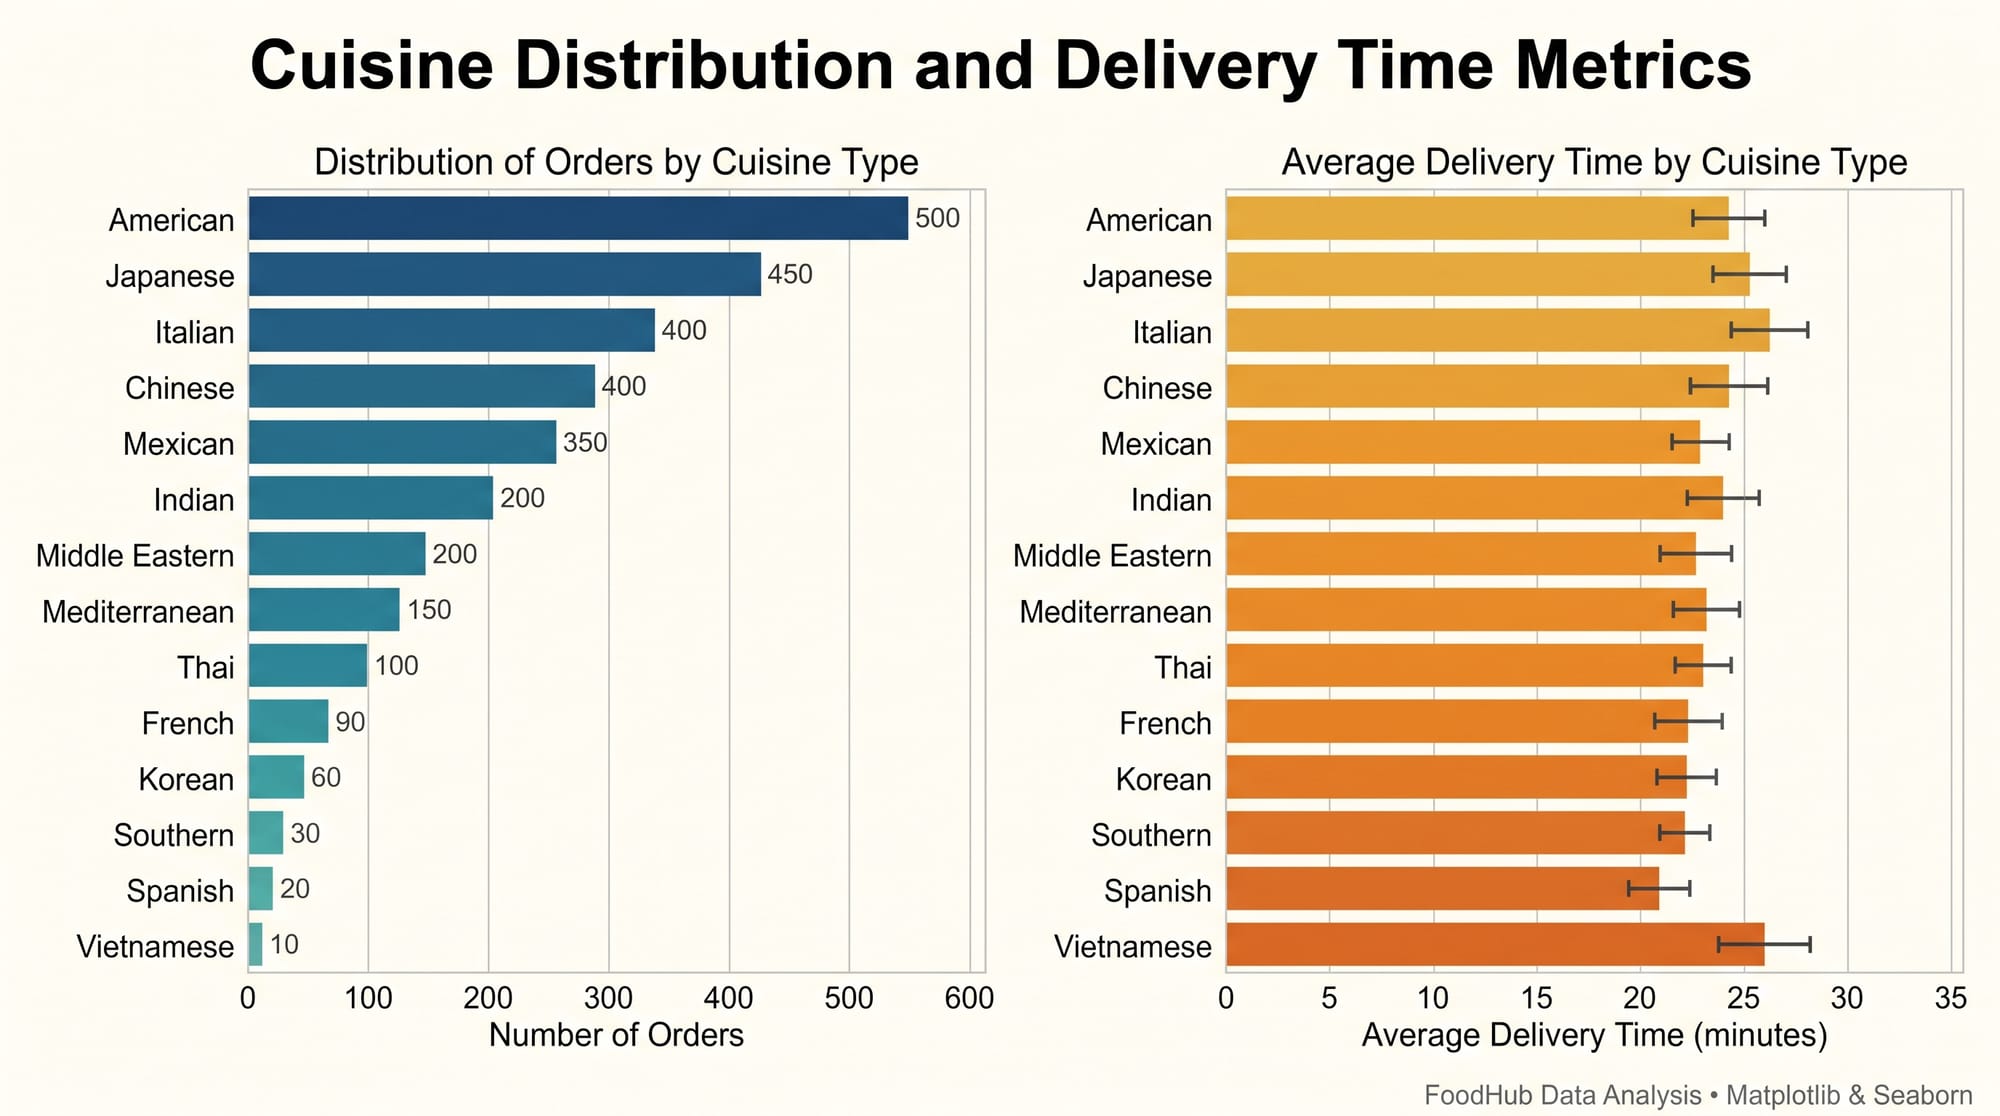
| 🎨 Visualisations dynamiques Seaborn & Matplotlib | Prise de décision rapide : Révèle immédiatement les cuisines les plus populaires et les pics de commande du week-end |
🎯 Segmentation des données sans note (rating) | Amélioration de l'expérience client : Isole les 736 commandes non notées pour cibler les relances de satisfaction |